Storage
Objetivo/Resumo
O conector Storage da Fluid oferece uma interface simplificada e padronizada para armazenar, recuperar, listar e deletar dados de forma eficiente e escalável no armazenamento dedicado ao seu tenant/workspace. Ele integra-se perfeitamente com as soluções de integração da Fluid, permitindo que você gerencie informações estruturadas por meio de identificadores únicos, sem demandar um armazenamento externo e se preocupar com gerenciamento de banco de dados. Cada identificador pode conter um ou mais conjuntos de dados organizados em pares de chave (key) e valor (value), facilitando a organização e o acesso aos dados conforme necessário.
Criando Conexão para o conector Storage
Para utilizar o conector Storage, é necessário criar uma Conexão e, em seguida, configurar o fluxo. Abaixo estão as instruções detalhadas.
Criando Conexão
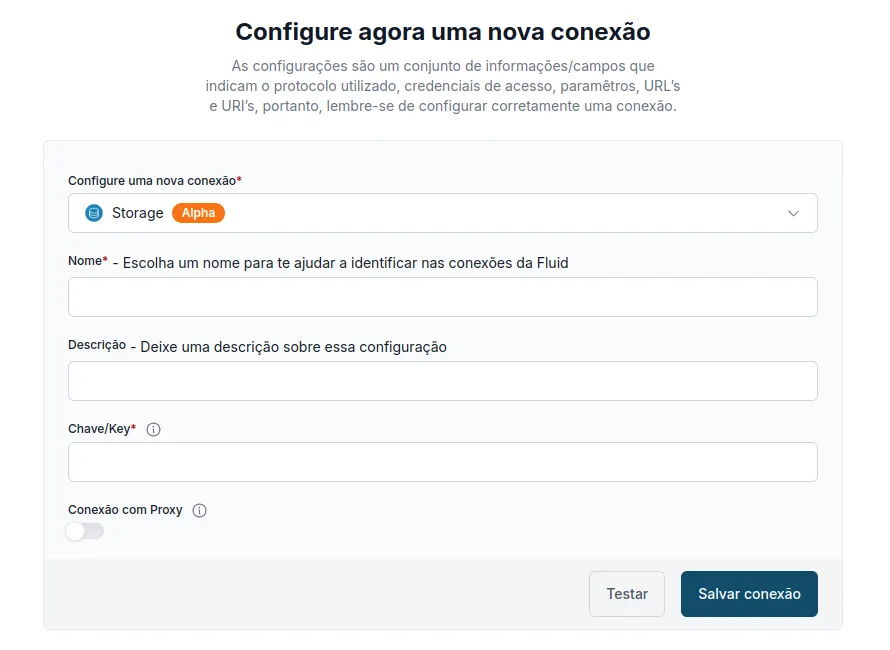
- Acessar o Painel Principal:
- Faça login na plataforma Fluid.
- No painel à esquerda, navegue até a opção "Conexões" e clique nela.
- Iniciar Nova Conexão:
- No canto superior direito, clique em "Nova Conexão".
- Seleção do Tipo de Conexão:
- Na tela de configuração, localize "Configure uma nova conexão" e selecione "Storage" da lista suspensa.
- Nome da Conexão:
- Forneça um nome descritivo para a conexão no campo "Nome".
- Descrição da Conexão:
- No campo "Descrição", forneça uma breve descrição da conexão.
- Chave/key:
- Insira a chave/key da tabela do storage que será utilizada pela API. Pode ser criada de acordo com o nome que você desejar.
Operações
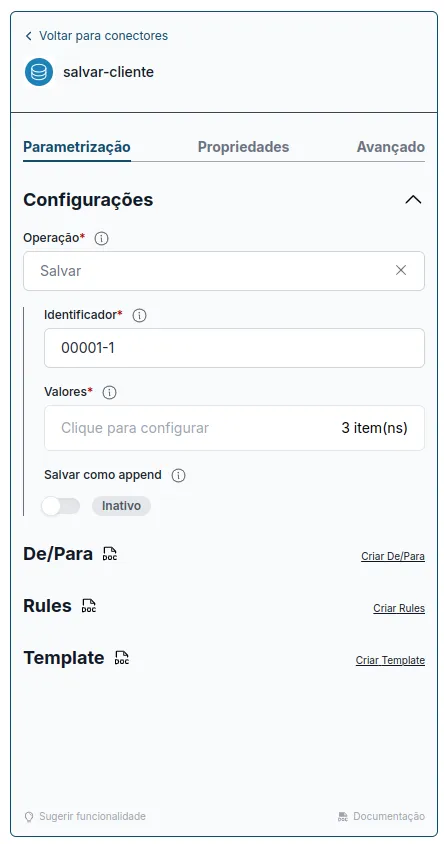
1. Salvar
Descrição: A operação de salvar permite que você armazene informações novas, atualize informações existentes, ou acrescente novas informações associadas a um identificador específico.
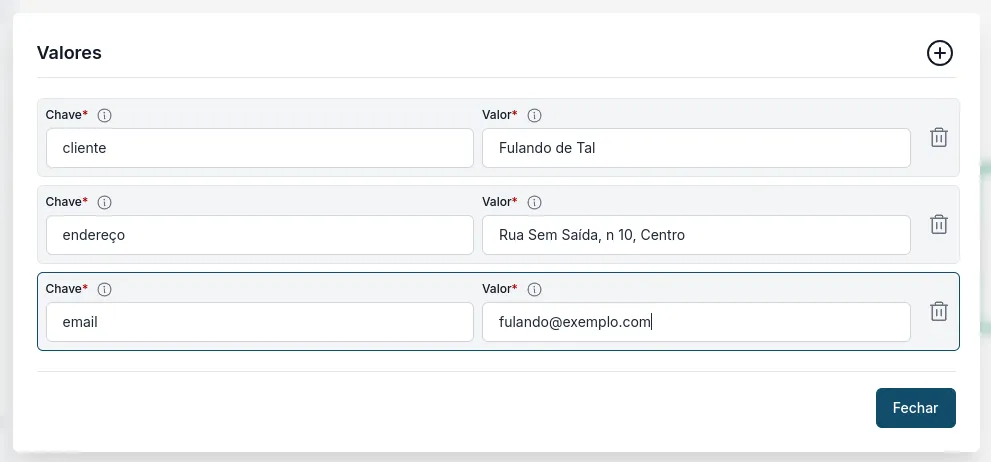
Como funciona: Ao salvar, você fornece um identificador único que será usado para agrupar os conjuntos de informações que deseja armazenar. Cada conjunto consiste em pares de chave (key) e valor (value), que representam os dados que você quer guardar. Ao salvar habilitando o campo Salvar como append os valores que informar serão acrescentados ao identificador caso ele já exista.
Exemplo prático: Imagine que você está salvando informações de clientes. O identificador pode ser o número do cliente, e os pares de key/values podem incluir nome, endereço e e-mail.
2. Recuperar Chave
Descrição: A operação de recuperar chave permite que você obtenha uma chave específica que esteja salva no identificador. Se a chave não existir, retornará uma mensagem informando que a chave não existe.\
Como funciona: Ao fornecer o identificador previamente usado para salvar as informações e informar a chave específica que deseja retornar, você pode recuperar o valor salvo para a chave informada dentro do identificador.
Exemplo prático: Se você salvou informações do cliente com o identificador 00001-1 e a chave nome e valor cliente de testes, ao utilizar a operação de recuperar chave com o identificador 00001-1 e a chave nome, você obterá o valor cliente de testes que foi salvo anteriormente para a chave nome.
{
    "id": "00001-1",
    "table_key": "*********",
    "values": {
        "nome": "cliente de testes"
    }
}
3. Verificar Chave
Descrição: A operação de verificar chave, verifica se a chave existe no identificador previamente informado do storage. Retorna true se a chave existir e false se não existir.
Como funciona: Ao fornecer o identificador previamente usado para salvar as informações e informar a chave específica que deseja verificar, será retornado um json informando se a chave existe ou não.
Exemplo prático: Se você salvou informações do cliente com o identificador 00001-1 e a chave nome, ao utilizar a operação verificar chave com o identificador 00001-1 e a chave nome, você obterá dentro da tag exist o valor true.
{
    "id": "00001-1",
    "table_key": "*********",
    "values": {
        "exist": true
    }
}
4. Listar
Descrição: A operação de listar permite que você veja todos os identificadores disponíveis juntamente com seus conjuntos de key/values associados.
Como funciona: Ao utilizar a operação de listar, você receberá uma lista de todos os identificadores armazenados no banco de dados, juntamente com os conjuntos de key/values associados a cada um deles.
Exemplo prático: Se você está gerenciando informações de vários clientes, a operação de listar fornecerá uma visão geral de todos os clientes existentes, cada um com suas respectivas informações armazenadas.
[
    {
        "id": "00001-1",
        "table_key": "clientes",
        "values": {
            "cliente": "Fulano de Tal",
            "endereço": "Rua Sem Saída, n 10, Centro",
            "email": "[email protected]"
        }
    },
    {
        "id": "00002-1",
        "table_key": "clientes",
        "values": {
            "cliente": "Ciclano de Tal",
            "endereço": "Rua Teste, n 20, Centro",
            "email": "[email protected]"
        }
    }
]
5. Listar Com Prefixo
Descrição: A operação listar com prefixo verifica no storage todos os identificadores que iniciem com o prefixo informado. Retorna todos os identificadores encontrados e seus respectivos conjuntos de chaves e valores.
Como funciona: Ao fornecer o prefixo do identificador, será retornado um JSON com todos os identificadores que iniciem com esse prefixo.
Exemplo prático: Se você salvou um cliente com o identificador 00001-1 e outro com o identificador 00002-1, e deseja buscar todos os identificadores que iniciem com o prefixo 0000, ao utilizar a operação listar com prefixo, passando o prefixo 0000, serão listados tanto o cliente 00001-1 quanto o cliente 00002-1.
[
    {
        "id": "00001-1",
        "table_key": "clientes",
        "values": {
            "cliente": "Fulano de Tal",
            "endereço": "Rua Sem Saída, n 10, Centro",
            "email": "[email protected]"
        }
    },
    {
        "id": "00002-1",
        "table_key": "clientes",
        "values": {
            "cliente": "Ciclano de Tal",
            "endereço": "Rua Teste, n 20, Centro",
            "email": "[email protected]"
        }
    }
]
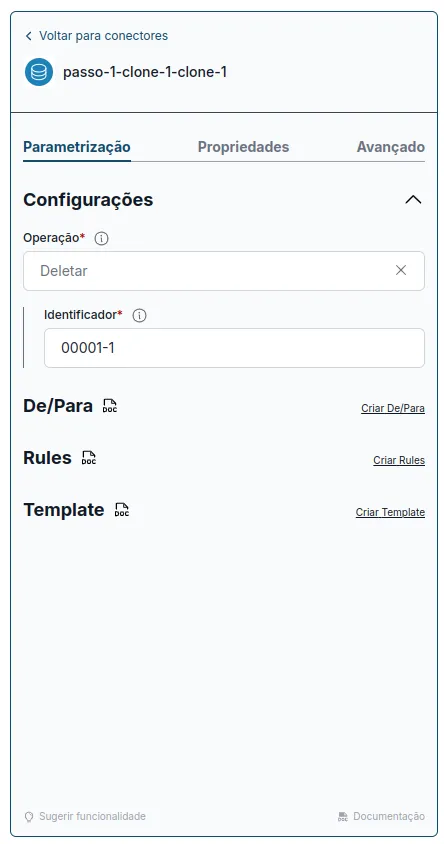
6. Deletar
Descrição: A operação de deletar permite que você remova completamente um identificador específico e todos os seus conjuntos de key/values associados.
Como funciona: Ao fornecer o identificador que deseja excluir, todos os dados associados a esse identificador serão permanentemente removidos do armazenamento.
Exemplo prático: Se um cliente não é mais ativo e você deseja remover todas as informações dele do sistema, você pode usar a operação de deletar com o identificador desse cliente para eliminar todas as informações associadas.
7. Deletar Chave
Descrição: A operação deletar chave permite excluir uma chave específica que esteja salva em um identificador. Após a execução, será retornada a quantidade de registros afetados no storage.
Como funciona: Ao fornecer o identificador previamente utilizado para salvar as informações, junto com a chave específica que deseja deletar, a chave será removida do identificador.
Exemplo prático: Se você salvou informações de um cliente com o identificador 00001-1 e a chave nome, ao utilizar a operação deletar chave com o identificador 00001-1 e a chave nome, essa chave será deletada, e será retornada a quantidade de registros afetados.
{
    "last_inserted_id": 0,
    "rows_affected": 1
}
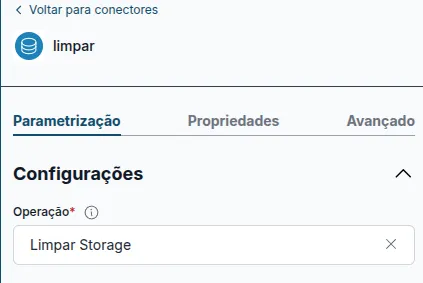
8. Limpar Storage
Descrição: A operação limpar storage permite deletar todos os identificadores de uma determinada conexão. Após a execução, será retornada a quantidade de registros afetados no storage.
Como funciona: Ao selecionar a operação o conector irá efetuar a limpeza completa do storage com base na conexão selecionada.
Exemplo prático:
9. Ler e Deletar
Descrição: A operação recuperar e deletar permite que você recupere os dados de um identificador específico e o remova em uma única operação atômica. Esta operação garante que você obtenha os dados antes da exclusão, evitando a perda de informações importantes.
Como funciona: Ao fornecer o identificador que deseja ler e deletar, o sistema primeiro recupera todos os dados associados a esse identificador e, em seguida, remove-o permanentemente do armazenamento. Esta operação é executada como uma transação atômica, garantindo consistência dos dados.
Exemplo prático: Se você tem um pedido temporário no storage que precisa ser processado e removido após o processamento, você pode usar a operação ler e deletar com o identificador desse pedido para obter os dados e removê-lo do storage em uma única operação.
Exemplo de retorno:
  {
      "id": "00001-1",
      "table_key": "pedidos_temporarios",
      "values": {
          "cliente": "Fulano de Tal",
          "produto": "Laptop",
          "quantidade": 1,
          "valor": "2500.00"
      }
} Vantagens:
- Operação atômica: Garante que a leitura e exclusão aconteçam em uma única transação
- Recuperação de dados: Permite obter os dados antes da exclusão
- Consistência: Evita condições de corrida em ambientes concorrentes
- Eficiência: Realiza duas operações em uma única consulta ao banco
Caso de uso: Ideal para cenários onde você precisa processar dados armazenados temporariamente e removê-los após o processamento.
10. Salvar em Lote
Descrição: Esta operação permite o processamento de múltiplos registros de uma só vez. É a forma mais eficiente de lidar com grandes volumes de dados (como listas de centenas de produtos ou clientes), garantindo alta velocidade e estabilidade na automação.
Como funciona: Ao receber uma lista de itens, o sistema aplica um processo de otimização automática antes da gravação:
- Consolidação de Dados: Se houver registros com o mesmo identificador (ID) no lote, o sistema mescla as informações e salva apenas o estado final consolidado, evitando redundâncias.
- Processamento em Massa: Em vez de realizar centenas de comunicações individuais com o banco de dados, o sistema agrupa as informações e as processas de forma massiva, o que reduz drasticamente o tempo total de execução.
- Flexibilidade: Você decide se quer que a nova informação substitua a antiga (overwrite) ou se deve apenas adicionar novos detalhes ao que já existe (append).
Exemplo prático: Ao processar uma lista de 500 pedidos via integração, o sistema organiza os dados, resolve possíveis duplicatas de ID presentes no lote e persiste todas as informações, garantindo que sua automação seja rápida e o banco de dados permaneça íntegro.
Exemplo de payload válido (Input):
Note que user_001 aparece duas vezes: os dados serão mesclados em um único registro final.
** Exemplo de payload inválido**:
Exemplo de retorno:
Explicação dos campos de retorno:
- total_items: Quantidade total de registros enviados no payload original.
- processed: Quantidade de itens que o sistema conseguiu analisar e processar, independentemente do resultado final.
- successes: Número de registros que foram processados e gravados com sucesso.
- errors: Soma de erros de validação estrutural e falhas na escrita no banco.
- details.item_errors: Lista falhas no formato do JSON enviado (ex: falta de campos obrigatórios).
- details.append / overwrite: Detalhamento técnico segregado por tipo de operação.
Por que os números totais podem ser diferentes dos comandos executados? Para otimizar a performance, realizamos um processo inteligente de compactação. Se você enviar 10 atualizações para o mesmo id em um único lote, o sistema executará apenas um comando no banco de dados com o estado final. No entanto, o retorno mostrará successes: 10, pois todos os seus pedidos originais foram processados com sucesso.
Vantagens:
- Alta Performance: Otimizado para processar grandes volumes de dados com latência mínima.
- Inteligência de Dados: Consolida informações repetidas no lote automaticamente, sem necessidade de lógica complexa no fluxo.
- Eficiência Operacional: Reduz o tráfego de rede e o consumo de recursos.
- Rastreabilidade: Retorno detalhado sobre o status de processamento de cada lote.
Caso de uso: Sincronização de catálogos, ingestão de dados de sensores/IoT, atualizações em massa de status de pedidos e migrações rápidas entre sistemas.
11. Deletar em Lote (Delete Bulk)
Descrição: Esta operação permite a remoção de múltiplos registros do storage de uma só vez, utilizando uma lista de identificadores. É a forma mais performática de realizar limpezas massivas de dados ou expurgar grandes volumes de informações obsoletas.
Como funciona: Ao receber uma lista de identificadores (IDs), o sistema processa a exclusão de forma otimizada:
- Processamento em Massa: Em vez de executar um comando de exclusão para cada item individualmente, o sistema agrupa os IDs e realiza a operação de forma massiva diretamente no banco de dados.
- Divisão em Sub-lotes: Para garantir a estabilidade e evitar sobrecarga, o sistema divide automaticamente listas muito grandes em grupos de 100 itens por vez.
- Foco em Performance: A operação é executada com baixa latência, focando na liberação rápida de espaço e recursos do armazenamento.
Exemplo prático: Se você precisar remover 1.000 registros de logs temporários ou pedidos cancelados antigos, basta enviar a lista de IDs. O sistema cuidará de agrupar as remoções para que o processo seja concluído em instantes, sem gerar centenas de chamadas individuais.
Exemplo de payload válido (Input):
O payload deve ser um array simples contendo apenas os textos dos identificadores (IDs) que deseja remover.
Exemplo de payload inválido:
Exemplo de retorno:
Explicação dos campos de retorno:
- total: Quantidade total de IDs que você enviou no payload original.
- processed: Quantidade de IDs que o sistema analisou e conseguiu processar, independentemente do resultado final.
- successes: Número total de IDs para os quais o comando de exclusão foi executado com sucesso.
- errors: Quantidade de registros que falharam durante a tentativa de exclusão (ex: falha de comunicação com o banco).
- rows_affected: Indica o número real de registros que foram efetivamente removidos do armazenamento.
Por que os números totais podem ser diferentes de rows_affected? O campo successes reflete que o comando para deletar aquele ID foi enviado e aceito pelo sistema. Já o campo rows_affected mostra quantos registros foram de fato removidos do banco. Por exemplo, se você tentar deletar um ID que não existe mais ou enviar o mesmo ID duas vezes no lote, o comando será um "sucesso" técnico, mas não aumentará o contador de registros afetados no banco de dados.
Vantagens:
- Alta Performance: Remoção em massa com mínima latência e tráfego de rede.
- Escalabilidade: Suporta listas extensas através do processamento automático por sub-lotes.
- Rastreabilidade: Informa quais grupos de IDs falharam, facilitando auditorias ou novas tentativas.
- Otimização de Recursos: Libera espaço de armazenamento de forma rápida e eficiente.
Caso de uso: Limpeza de logs e dados temporários, expurgo de registros antigos por política de retenção, revogação massiva de tokens ou remoção de dados após finalização de processos.
12. Listar com Paginação
Descrição: Esta operação permite recuperar grandes conjuntos de dados de forma organizada e em partes (páginas). É essencial para exibir listas de informações em interfaces ou processar registros em etapas, evitando sobrecarga de memória e garantindo a fluidez do sistema.
Como funciona: O sistema utiliza dois parâmetros principais para navegar pelos dados de uma tabela e um opcional para filtrar por prefixo:
- Limite (limit): Define o número máximo de registros que você deseja receber em uma única chamada.
- Deslocamento (offset): Indica quantos registros o sistema deve "pular" antes de começar a listar, permitindo que você navegue entre as páginas de resultados.
- Prefixo (prefix): (Opcional) Permite filtrar os resultados para incluir apenas os identificadores que começam com um determinado prefixo, facilitando a segmentação dos dados.
- Consistência: Os dados são retornados em uma ordem fixa (por identificador), garantindo que você não veja itens repetidos ou perca registros ao mudar de página.
Exemplo prático:
- Se você possui 1.000 clientes cadastrados e deseja exibir 50 por vez em seu dashboard, basta definir o limit como 50. Para visualizar a "página 2", você mantém o limit em 50 e define o offset como 50 (pulando os primeiros 50 que já foram vistos).
- Se quiser listar apenas os clientes cujo identificador começa com "cli*", basta usar o parâmetro prefix com o valor "cli*". O sistema retornará apenas os registros que correspondem a esse critério, facilitando a navegação em grandes volumes de dados.
Exemplo de parametrização: [imagem 1](Aurelio aqui a imagem que lhe enviei)
Dica: Para percorrer toda a base, basta incrementar o offset somando o valor do limit a cada nova consulta.
Exemplo de retorno:
Explicação dos campos de retorno:
- items: Lista contendo os dados detalhados dos registros encontrados na página atual.
- count: Quantidade de registros retornados nesta chamada específica.
- limit: O limite que foi aplicado à consulta.
- offset: O ponto de partida (deslocamento) utilizado para gerar esta página.
- total_items: O número total de registros disponíveis na tabela, independentemente da paginação.
- total_pages: O número total de páginas disponíveis, calculado com base no total de itens e no limite.
- current_page: A página atual que está sendo visualizada, calculada a partir do offset e do limite.
- has_next_page: Indica se existe uma próxima página de resultados além da atual.
- has_previous_page: Indica se existe uma página anterior de resultados antes da atual.
Vantagens:
- Navegação Otimizada: Permite percorrer milhões de registros sem perda de performance.
- Economia de Recursos: Carrega apenas o necessário por vez, mantendo a aplicação leve e rápida.
- Previsibilidade: A ordenação garantida evita confusão visual ao paginar os dados.
- Escalabilidade: Ideal para alimentar grids, tabelas e processos de exportação de dados em massa.
Caso de uso: Criação de listas paginadas em painéis administrativos, relatórios de histórico, exportação de dados em lotes (E-mail Marketing, faturamento) e busca de logs por categorias.
Caso de Uso: Gerenciamento de pedidos pendentes no ERP
Cenário
Você está implementando uma integração de pedidos entre o seu e-commerce e ERP. Se o cliente associado ao pedido não estiver cadastrado no ERP, o pedido não pode ser registrado e deve ser salvo temporariamente em um storage até que o cliente seja cadastrado e o pedido reenviado.
Fluxo do caso de uso
1. Cadastro de pedido no ERP
Objetivo: Tentar cadastrar um pedido no ERP.
Passos:
- Enviar dados do pedido: O sistema envia dados do pedido para o ERP.
- Verificar resposta do ERP:
- Se o cliente associado ao pedido já estiver cadastrado, o pedido é registrado com sucesso.
- Se o cliente não estiver cadastrado, o ERP retorna um erro.
Exemplo:
- Pedido: Pedido123
- Cliente: Cliente456 (não cadastrado no ERP)
- Produto: Laptop
- Quantidade: 1
2. Salvar Pedido no Storage
Objetivo: Se o pedido não puder ser cadastrado no ERP devido ao cliente não estar registrado, salvar o pedido no storage para processamento futuro.
Passos:
- Definir Identificador: Use um identificador único para o pedido, como o ID do pedido (Pedido123).
- Salvar Dados:
- Chaves e Valores:
- Cliente: Cliente456
- Produto: Laptop
- Quantidade: 1
Operação: Salvar
3. Listar pedidos salvos no Storage
Objetivo: Recuperar todos os pedidos que foram salvos no storage para tentar reenviá-los ao ERP.
Passos:
- Executar Operação de Listar: Liste todos os identificadores e seus pares chave/valor armazenados.
Operação: Listar
Exemplo de Resultado:
- Identificador: Pedido123
- Cliente: Cliente456
- Produto: Laptop
- Quantidade: 1
Objetivo: Listar os pedidos pendentes de envio e direcionar para o fluxo de reenvio do pedido.
4. Deletar pedido do Storage
Objetivo: Após o pedido ser cadastrado com sucesso no ERP, remova-o do storage para evitar processamento duplicado.
Passos:
- Definir Identificador: Use o mesmo identificador do pedido (Pedido123).
Operação: Deletar
Resumo das Funções
- Salvar: Adiciona ou substitui pares chave/valor para um identificador.
- Recuperar: Obtém pares chave/valor para um identificador específico.
- Listar: Mostra todos os identificadores e seus pares chave/valor.
- Deletar: Remove um identificador e seus dados do storage.
Dicas e Considerações
- Escolha de Conexão: Certifique-se de selecionar a conexão apropriada para o tipo de dados que está manipulando.
- Uso de Identificadores: Use identificadores únicos para evitar sobrescrever dados inadvertidamente.
Conclusão
O Conector de Storage da Fluid é uma ferramenta essencial para a gestão eficiente de dados, oferecendo operações intuitivas e robustas para armazenar, recuperar, listar e deletar informações sem se preocupar em gerenciar banco de dados.
Ele se integra perfeitamente com outras soluções da Fluid, proporcionando uma experiência de uso coesa e simplificada. Com sua capacidade de gerenciar dados estruturados através de identificadores únicos, o conector de Storage não apenas facilita a organização dos dados, mas também garante que eles sejam acessíveis e manipuláveis conforme as necessidades de seu aplicativo ou sistema. Independentemente da complexidade dos dados, o Conector de Storage oferece uma solução confiável e escalável para todas as suas necessidades de armazenamento.